
GPT Image 2 Anime-Key-Visual-Generator
Ein praktischer Generator für Anime-Key-Visuals, die einen Ort zusammenhalten – entwickelt und getestet an A Silent Voice, mit vier veröffentlichten Werken und einem ehrlichen Vergleich mit Krea 2.
GPT Image 2 Anime-Key-Visual-Generator
Diese Generatorseite erfüllt eine Aufgabe: aus einer Anime-Welt Key Visuals zu machen, die eine Szene räumlich und erzählerisch zusammenhalten – zwei Menschen auf einer Brücke, ein Klassenzimmer, nachdem alle gegangen sind, ein Notizbuch, das mehr bedeutet, als eine der Figuren auszusprechen bereit ist. GPT Image 2 ist die detailorientierte Wahl: langsamer und teurer als schnelle Grafikmodelle, aber ungewöhnlich gut darin, einen Ort mit klar erkennbarer Tiefe aufzubauen.
Alles, was folgt, entstand in A Silent Voice, einer spielbaren Welt mit 27 Materialien. Sie enthält vier veröffentlichte Key Visuals: zwei Prompts, die jeweils unverändert mit GPT Image 2 und Krea 2 ausgeführt wurden. Das Prompt-Gerüst, die Einstellungen und die Korrekturklauseln wurden tatsächlich so verwendet; sie sind keine nachträglich bereinigte Fassung.
Was GPT Image 2 hier besser macht
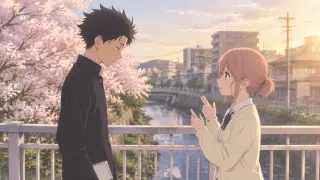
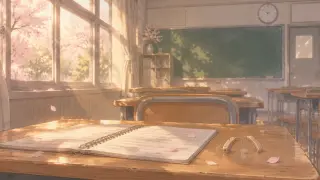
Anime-Key-Art scheitert meist auf eine von zwei Arten: Sie ist schön, aber räumlich unmöglich, oder räumlich korrekt und vollkommen leblos. GPT Image 2 neigt seltener zum ersten Problem, als man erwarten würde. Es gliedert eine Szene in Ebenen – Vordergrundobjekt, Figuren, Mittelgrund, Hintergrund – und hält sie stimmig. Auf der Brücke bedeutet das: Das Geländer bleibt vorn, der Fluss führt darunter in die Tiefe, und die Stadt liegt in glaubhaftem Abstand dahinter. Im leeren Klassenzimmer bedeutet es, dass das Notizbuch auf dem Tisch liegt, statt darüber zu schweben, und die Tischreihen tatsächlich in die Tiefe führen.
- Räumliche TiefeBaut Vordergrund, Motiv und Hintergrund als getrennte Ebenen auf. Man kann zeigen, wo der Fluss verläuft, wo das Geländer steht und in welche Richtung sich die Stadt erstreckt. Dadurch lässt sich das Bild als Hintergrund wiederverwenden.
- Kleine Requisiten, die erhalten bleibenEin Hörgerät, eine Spiralbindung, ein Zifferblatt, ein Blütenblatt auf einer Seite. GPT Image 2 hält solche Details eher erkennbar, statt sie in Textur aufzulösen. Das ist wichtig, wenn eine Requisite die Geschichte trägt.
- Kontrolliertes LichtBewältigt kontrastarmes Licht am späten Nachmittag, ohne das ganze Bild abzuflachen. Die Schatten bleiben weich, das Fenster bleibt hell, und die Figuren heben sich vor beidem klar ab.
Ein Prompt-Gerüst, das trägt
Die Prompts, die funktionieren, sind keine Gedichte. Sie sind eine Einstellungsliste mit einer Stimmungsklausel am Ende. Baue sie in einer festen Reihenfolge auf, damit du eine Ebene nach der anderen überprüfen kannst: Format, Ort, Figuren, Hindernis, Licht, Stil, Ausschlüsse. Wenn das Bild nicht stimmt, weißt du, welche Klausel du ändern musst.
Format
„Anime-Key-Visual, filmisches 16:9.“ Lege Seitenverhältnis und Zweck vor allem anderen fest. Verlange kein Plakat, wenn du einen Hintergrund brauchst.
Ort
Nenne Ort und Tageszeit in einem Satz: „eine schmale Fußgängerbrücke über einem flachen Fluss in einer japanischen Stadt, später Nachmittag.“
Figuren
Gib jeder Figur ein Merkmal ihrer Silhouette und eine emotionale Angabe: Alter, Haare, Uniform, Haltung, Blickrichtung. Schreibe keine Biografie.
Hindernis
Platziere einen Gegenstand zwischen ihnen oder in ihren Händen: ein Geländer, ein Notizbuch, eine Kamera, eine Tasche. Der Gegenstand gibt den Händen etwas zu tun und der Szene einen physischen Bezugspunkt.
Licht
Wähle ein Hauptlicht und eine Aufhellung. „Warmes, tief stehendes Sonnenlicht und lange, weiche Schatten“ genügt. Vermeide drei Lichtquellen, es sei denn, die Szene handelt von Verwirrung.
Stilfestlegung
Wiederhole jedes Mal denselben Stilsatz: Linienqualität, Transparenz der Farben, Kontraststärke, Verhalten der Schatten. Das hält eine Serie einheitlich.
Ausschlüsse
Schließe mit den Dingen, die du nicht möchtest: kein Text, keine Buchstaben, keine Beschilderung, kein Wasserzeichen, kein Logo. Anime-Modelle erfinden gern Schulschilder und Titeltafeln.
Der Brücken-Prompt mit Erläuterungen
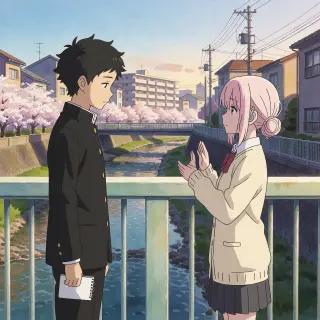
Das Brückenbild ist eine Zweieraufnahme in einer gestalteten Umgebung. Der Prompt nennt Shōya und Shōko, gibt beiden ein Merkmal ihrer Silhouette – zerzaustes schwarzes Haar und eine dunkle Uniform; blassrosa Haar in einem tiefen Dutt und eine cremefarbene Strickjacke – und dann einen gemeinsamen Gegenstand: das Notizbuch. Er platziert ein Hörgerät hinter Shōkos Ohr, weil die Geschichte von Kommunikation handelt und die Requisite sichtbar sein soll, ohne zum Etikett zu werden. Das Geländer soll das Licht auffangen und so die Brücke in eine horizontale Linie durch das Bild verwandeln.
Der Prompt sagt nicht „traurig“ oder „romantisch“. Er sagt „warmes, tief stehendes Sonnenlicht und lange, weiche Schatten“ und überlässt die emotionale Arbeit der Inszenierung. Das ist der Unterschied zwischen einem Key Visual und der Illustration eines Adjektivs.
Das Ergebnis ist bewusst keine Geständnisszene. Die Figuren sind einander zugewandt, berühren sich aber nicht; Shōkos Hände sind halb erhoben, was der Anfang oder das Ende einer Gebärde sein könnte. Das Notizbuch liegt geschlossen in Shōyas Hand. Jedes Element ist eine Frage, die die nächste Szene beantworten kann.
Warum das leere Klassenzimmer der schwierigere Test ist
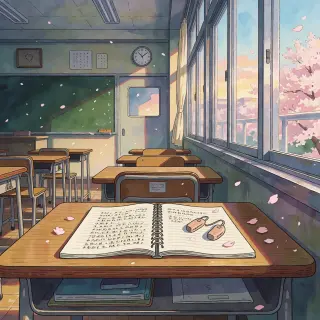
Nimm die Gesichter weg, und das Modell hat nichts mehr, hinter dem es sich verstecken kann. Der zweite Prompt beschreibt ein Stillleben: ein offenes Notizbuch, ein Paar Hörgeräte, Kirschblütenblätter, leere Tische, eine Uhr und eine grüne Tafel. Es muss Abwesenheit vermitteln, ohne eine einzige Figur zu zeigen. GPT Image 2 löst das, indem es den Raum als eine Folge zurückweichender Ebenen behandelt und den Tisch im Vordergrund ins Zentrum rückt. Die linierten Seiten des Notizbuchs, die Rundung der Hörgeräte und der Staub im Licht werden als Dinge mit Gewicht dargestellt.
Krea 2 erzeugt mit demselben Prompt ein kräftigeres, flacheres Bild: Das Fenster wird zur Plakatform, der Sonnenuntergang ist satter, und Notizbuch und Hörgeräte sind auch in kleiner Darstellung sofort erkennbar. Es ist das bessere Vorschaubild. GPT Image 2 ist die bessere Erinnerung. Zu wissen, welches von beiden du brauchst, ist bereits der größte Teil der Entscheidung.
GPT Image 2 und Krea 2 bei identischen Prompts
- Wähle GPT Image 2, wenndie Szene Tiefe, eine wiederverwendbare räumliche Anordnung, mehrere kleine Requisiten oder einen stillen emotionalen Moment braucht, der davon abhängt, wo die Menschen stehen. Plane eine langsamere Generierung und höhere Kosten pro Bild ein.
- Wähle Krea 2, wenndu Geschwindigkeit, Menge, eine starke Silhouette oder eine auf das Vorschaubild ausgelegte Optik brauchst. Es kostet pro Bild ungefähr ein Viertel und ist deutlich schneller, akzeptiert aber nur Texteingaben und hat bekanntermaßen Schwierigkeiten mit lesbarem Text.
Der ehrliche Vergleich lautet nicht: „Welches Modell ist besser?“ Er lautet: „Welchen Fehler verträgt diese Szene?“ GPT Image 2 kann zu viele Details ausarbeiten und überladen wirken; Krea 2 kann eine Szene zum Plakat abflachen, wenn du einen Raum brauchtest. Lass beim ersten Prompt einer Serie beide Modelle laufen, wähle das, dessen Schwächen du korrigieren kannst, und hör dann auf zu vergleichen: Bau die Serie.
Einstellungen, auf die es ankommt
- Größe Verwende 2048×1152 für ein Key Visual im Format 16:9. Wenn das Bild hinter einem Titel stehen soll, halte das obere Drittel ruhig und sage das im Prompt.
- Qualität Hohe Qualität lohnt sich für ein Hauptbild mit kleinen Requisiten. Erzeuge zum Erkunden zunächst einen günstigeren Durchlauf und lass nur die gewählte Komposition noch einmal in hoher Qualität rendern.
- Seitenverhältnis Krea 2 lieferte bei derselben Vorgabe ein quadratisches Bild. Wenn ein Hintergrund im Format 16:9 unverzichtbar ist, prüfe das Ergebnis, bevor du den Rest der Serie darauf aufbaust.
- Referenzbilder GPT Image 2 akzeptiert Referenzbilder; Krea 2 verarbeitet nur Text. Verwende eine Referenz, wenn das Gesicht einer Figur oder die räumliche Anordnung eines Ortes über mehrere Szenen hinweg gleich bleiben muss.
- Iteration Ändere jeweils nur eine Klausel. Wenn du nach einem misslungenen Bild den ganzen Prompt umschreibst, erfährst du nicht, welches Wort das Problem verursacht hat.
Fünf typische Fehler und ihre Korrekturen
- Die Szene wird zum Plakat Füge ein Vordergrundobjekt und eine zweite Ebene hinzu. „Geländer unmittelbar im Vordergrund, dahinter der Fluss, dahinter die Stadt“ erzwingt Tiefe.
- Die Gesichter weichen vom Figurenmodell ab Reduziere die Zahl der Figuren im Bild und beschreibe pro Person ein Merkmal ihrer Silhouette. Zwei Figuren mit klaren Haarformen sind besser als fünf mit ausführlichen Biografien.
- Die Hände verschwinden oder verschmelzen Gib den Händen eine Aufgabe: ein Notizbuch halten, auf einem Geländer ruhen, halb zu einer Gebärde erhoben sein. Bei leeren Händen improvisieren Anime-Modelle oft schlecht.
- Das Modell erfindet Beschilderung Ergänze die Ausschlussklausel um „kein Text, keine Buchstaben, keine Beschilderung, kein Wasserzeichen, kein Logo“. Prüfe anschließend die Tafel und das Plakat an der Wand.
- Das Licht ist schön, aber die Geschichte fehlt Entferne eine Lichtquelle und benenne das emotionale Hindernis. Wenn es im Bild noch immer um den Sonnenuntergang geht, ging es im Prompt um den Sonnenuntergang.
Negative Prompts und Ausschlüsse
Nutze Ausschlüsse für Dinge, die eine Serie stören, nicht für alles, was dir missfällt. Text, Wasserzeichen, Logos und Benutzeroberflächen sind die vier verlässlichen Kandidaten. Ergänze „keine zusätzlichen Finger“ nur, wenn Hände sichtbar und zentral sind; sonst verschwendet es Platz im Prompt. Ergänze „keine moderne Beschilderung“, wenn die Stadt wie eine bestimmte japanische Stadt wirken soll und nicht wie eine beliebige Anime-Stadt. Halte die Ausschlussliste kurz und gleichbleibend, damit du die Durchläufe vergleichen kannst.
Von einem Bild zu einer Welt
Schreibe zuerst die Szenenkarte
Entscheide, wer in der Szene ist, was die Figuren wollen und was sie nicht sagen werden. Der Prompt übersetzt diese Karte; er ersetzt sie nicht.
Generiere den Schauplatz
Generiere den Ort ohne Figuren oder nur mit Figuren in der Ferne. Prüfe die Ebenen, das Licht und den wiederverwendbaren Hintergrund.
Füge die Figuren hinzu
Setze die Figuren in den freigegebenen Schauplatz. Halte die Stilklausel identisch, sonst driftet die Serie auseinander.
Veröffentliche das Paar
Veröffentliche die Versionen von GPT Image 2 und Krea 2 gemeinsam. Der Vergleich ist für Leserinnen und Leser nützlich und hält dich ehrlich bei der Frage, was jedes Modell leistet.
Was dieser Generator nicht ist
Er ist keine Maschine für durchgehend konsistente Figuren. GPT Image 2 kann ein Erscheinungsbild über einige Bilder hinweg beibehalten, besonders mit Referenzen, garantiert aber nicht dasselbe Gesicht in einer Visual Novel mit zwanzig Szenen. Er ist kein Werkzeug für Typografie; wenn das Bild einen Titel braucht, füge ihn im Layout hinzu, nicht im Prompt. Und er ersetzt keine Inszenierung. Ein Prompt voller Stimmungswörter ohne Anordnung der Figuren erzeugt eine schöne Postkarte von nichts.
Kosten, Geschwindigkeit und wann sich das günstigere Modell lohnt
GPT Image 2 liegt am oberen Ende des Bildbudgets und ist relativ langsam. Für ein Hauptbild oder einen Hintergrund, den du wiederverwenden wirst, ist das in Ordnung; für eine Kontaktübersicht mit zehn Ideen ist es Verschwendung. Der praktische Ablauf: Erkunde mit Krea 2, wähle die Komposition und erstelle das gewählte Bild anschließend in GPT Image 2 neu – mit demselben Gerüst und einer strengeren Stilfestlegung. So bekommst du die Geschwindigkeit des einen Modells und die Tiefe des anderen.
Fragen zu diesem Generator
- Brauche ich ein Referenzbild? Für das erste Bild nicht. Wohl aber, wenn das Gesicht einer Figur oder die räumliche Anordnung eines Ortes über eine Serie hinweg identisch bleiben muss. GPT Image 2 akzeptiert Referenzen; Krea 2 nicht.
- Warum sieht mein Anime-Bild wie eine Fotografie aus? Deine Stilklausel ist zu schwach. Benenne Linienqualität, transparente Farben und kontrastarmes Schattenverhalten ausdrücklich und wiederhole bei jedem Durchlauf denselben Satz.
- Kann ich Text im Bild generieren? Vermeide es. Beide Modelle sind bei lesbarem Text unzuverlässig, und Krea 2 ist hier bekanntermaßen besonders schwach. Füge den Titel stattdessen im Seitenlayout hinzu.
- Wie viele Bilder sollte eine Welt haben? Vier reichen aus, um einen Stil zu belegen: zwei Prompts, zwei Modelle. Füge nur dann weitere hinzu, wenn eine Szene einen neuen Blickwinkel oder eine neue Figur braucht.
Generiere dein erstes Anime-Key-Visual
Die Brücke und das leere Klassenzimmer sind bereits in Versionen beider Modelle veröffentlicht. Öffne die Welt, kopiere das Prompt-Gerüst und gestalte das nächste Bild selbst.