
GPT Image 2 动漫主视觉生成器
一款用于创作空间完整的动漫主视觉的实用生成器——在《声之形》中构建并测试,包含四件已发布作品,以及与 Krea 2 的坦诚比较。
GPT Image 2 动漫主视觉生成器
这个生成器页面只做一件事:将动漫世界转化为场景空间完整的主视觉——桥上的两个人、众人离去后的教室、一本承载着角色不愿说出口的话的笔记本。GPT Image 2 是注重细节的选择:比快速图形模型更慢、成本更高,却尤其擅长营造层次清晰的空间。
以下所有作品均创作于《声之形》,一个包含27项素材的可玩世界。其中有四张已发布的主视觉:两条提示词,各自在 GPT Image 2 和 Krea 2 上原样运行。提示词框架、设置和修正语句均为实际使用的内容,并非事后整理美化的版本。
GPT Image 2 在这里做得更好的地方
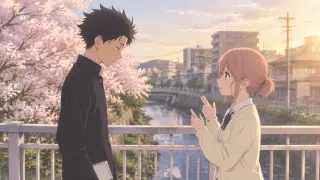
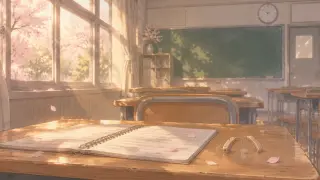
动漫主视觉通常有两种失败方式:画面很美,空间关系却不可能成立;或者空间关系正确,却毫无生气。GPT Image 2 陷入第一种问题的次数比想象中少。它将场景分成前景物件、人物、中景和背景等层次,并保持彼此一致。在桥上,这意味着栏杆始终在前方,河流从桥下向远处延伸,城镇则以可信的距离坐落在后方。在空教室里,这意味着笔记本放在桌上,而非漂浮在桌面上方,成排的课桌也确实向远处延伸。
- 空间纵深将前景、主体和背景构建为独立的层次。你可以指出河流在哪里、栏杆位于何处、城镇向哪个方向延伸。这使图像可以作为背景底图重复使用。
- 保留下来的小道具助听器、螺旋装订线、钟面、纸页上的花瓣。GPT Image 2 往往能让这些细节清晰可辨,而不是将它们融入纹理。当道具承担叙事作用时,这一点很重要。
- 受控的光线能够处理低对比度的傍晚光线,而不让整个画面变得扁平。阴影保持柔和,窗户依然明亮,人物在两者衬托下仍清晰可辨。
经得起检验的提示词框架
有效的提示词不是诗,而是一份末尾附有氛围语句的镜头清单。按固定顺序编写,便于逐层排查:格式、地点、人物、阻隔物、光线、风格、排除项。如果生成的图像有问题,就能知道该修改哪条语句。
格式
“动漫主视觉,电影感,16:9。”先确定画幅比例和用途。如果需要背景底图,就不要要求生成海报。
地点
用一句话说明地点和时间:“日本小镇上一座跨越浅河的狭窄人行桥,午后晚些时候。”
人物
为每个角色提供一项外形特征和一项情绪信息:年龄、发型、制服、姿态、视线方向。不必写人物传记。
阻隔物
在人物之间或手中放一件物品:栏杆、笔记本、相机或书包。物品让手有所动作,也让场景有了具体的牵系。
光线
选择一处主光和一处补光。“温暖的低角度阳光和柔长的阴影”就足够了。除非场景表现的是混乱,否则避免使用三个光源。
锁定风格
每次重复同一句风格描述:线条质感、色彩通透度、对比度、阴影表现。这能让系列保持一致。
排除项
最后列出不想要的内容:无文字、无字母、无标牌、无水印、无标志。动漫模型很喜欢凭空创造学校标牌和标题卡。
桥上场景提示词解析
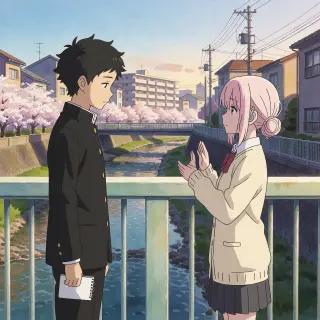
桥上的图像是一张包含建筑环境的双人画面。提示词写明了将也和硝子,为两人各给出一项外形特征:凌乱的黑发与深色校服;浅粉色低发髻与奶油色开衫。接着,它给了两人一件共同的物品:笔记本。硝子耳后戴着助听器,因为故事关乎交流,这件道具应当可见,却不应沦为标签。提示词还要求栏杆反射光线,使桥成为横贯画面的一条水平线。
提示词没有写“悲伤”或“浪漫”,而是写了“温暖的低角度阳光和柔长的阴影”,让场面调度承担情绪表达。这就是主视觉与形容词插画之间的区别。
最终画面有意避开了告白场景。两人面向彼此,却没有接触;硝子的双手半抬,可能是一个手势的开始,也可能是结束。将也手中的笔记本合着。每个元素都是一个问题,留待下一场戏回答。
为什么空教室是更难的考验
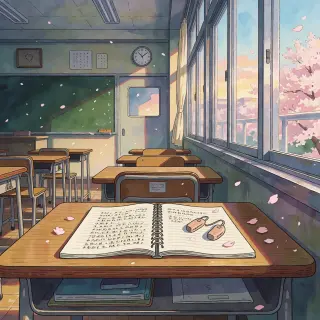
去掉面孔,模型就无处藏拙。第二条提示词描绘的是一幅静物:摊开的笔记本、一副助听器、樱花花瓣、空课桌、时钟和绿色黑板。它必须在没有任何角色的情况下传达缺席感。GPT Image 2 将房间处理为一组向远处延伸的层次,让前景课桌承载视觉焦点。笔记本上的横线、助听器的弧度和光线中的尘埃,都被呈现为有分量的实体。
Krea 2 使用相同提示词生成的图像更醒目、更平面:窗户变成海报般的形状,夕阳饱和度更高,笔记本和助听器在小尺寸下也能一眼辨认。它更适合做缩略图。GPT Image 2 则更像一段记忆。知道自己需要哪一种,选择就完成了一大半。
相同提示词下的 GPT Image 2 与 Krea 2
- 何时选择 GPT Image 2当场景需要纵深、可重复使用的空间布局、多个小道具,或依靠人物站位传达的安静情绪时。需要为更慢的生成速度和更高的单张成本留出预算。
- 何时选择 Krea 2当你需要速度、数量、鲜明的轮廓或优先考虑缩略图效果时。它的单张成本约为前者的四分之一,速度也快得多,但只接受文本输入,而且已知难以生成清晰可读的文字。
坦诚的比较不是“哪个模型更好”,而是“这个场景能承受哪种缺陷?”GPT Image 2 可能过度渲染,显得繁琐;Krea 2 则可能在你需要一个房间时,将场景压平成海报。用系列的第一条提示词同时运行两者,选出缺陷可以修正的那个,然后停止比较,开始构建整个系列。
重要的设置
- 尺寸 16:9 主视觉使用 2048×1152。如果图像将用作标题背景,给上方三分之一留出安静的空间,并在提示词中说明。
- 质量 对于包含小道具的主图,高质量设置值得使用。探索阶段先以较低成本生成一版,只对选定的构图重新进行高质量生成。
- 画幅比例 Krea 2 在相同要求下生成了一张正方形图像。如果必须使用 16:9 底图,在围绕它制作系列其余部分之前,先检查输出结果。
- 参考图 GPT Image 2 接受参考图;Krea 2 只接受文本输入。当角色面孔或地点布局需要在不同场景中保持一致时,使用参考图。
- 迭代 一次只修改一条语句。如果生成效果不好后就重写整条提示词,你便无法知道是哪个词导致了问题。
五种常见问题及修复方法
- 场景变成了海报 加入一个前景物件和第二个层次。“紧贴前景的栏杆,栏杆后方的河流,河流后方的城镇”能够迫使画面产生纵深。
- 面孔偏离角色设定 减少画面中的人物数量,并为每个人描述一项外形特征。两个发型轮廓清晰的人物,胜过五个附有详细传记的人物。
- 手消失或融合在一起 给手安排动作:拿着笔记本、搭在栏杆上,或半抬着做手势。空着的手往往是动漫模型自由发挥失误的地方。
- 模型凭空创造标牌 在排除语句中加入“无文字、无字母、无标牌、无水印、无标志”。然后检查黑板和墙上的海报。
- 光线很美,故事却消失了 移除一个光源,并明确人物之间的情感阻隔。如果图像呈现的仍然只是夕阳,那么提示词写的就是夕阳。
负面提示词与排除项
排除项应用于会破坏系列一致性的内容,而不是所有你不喜欢的东西。文字、水印、标志和界面元素是四项稳妥的排除内容。只有当手清晰可见且处于画面中心时,才加入“不要多余的手指”;否则只会浪费提示词空间。当城镇应当像一座具体的日本小镇,而非千篇一律的动漫城市时,加入“无现代标牌”。保持排除列表简短、稳定,才能比较各次生成结果。
从一张图像到一个世界
先写场景卡
确定谁在场景中、他们想要什么,以及他们不会说出什么。提示词是对这张卡片的转译,而不是它的替代品。
生成场景空间
生成没有人物或只有远处人物的地点画面。检查空间层次、光线和可重复使用的背景底图。
加入人物
将角色放入已确认的场景空间。风格语句必须保持完全一致,否则系列会逐渐偏离。
成对发布
同时分享 GPT Image 2 和 Krea 2 版本。这样的比较对读者有用,也能让你如实看待每个模型的表现。
这个生成器不能做什么
它不是一台角色一致性机器。GPT Image 2 可以在少数几张图像中保持角色外观,尤其是在使用参考图时,但无法保证在包含二十个场景的视觉小说中始终生成同一张脸。它也不是排版工具;如果图像需要标题,应在版面中添加,而不是写进提示词。它同样不能替代场面调度。充满氛围词却没有人物走位的提示词,只会生成一张漂亮却空无一物的明信片。
成本、速度与何时使用更便宜的模型
GPT Image 2 在图像生成预算中属于成本较高的一档,速度也相对较慢。用它制作主图或会重复使用的背景底图是合适的,用来制作包含十个创意的缩略图样张则是一种浪费。实用的工作流程是先用 Krea 2 探索、选定构图,再用相同框架和更严格的风格锁定,在 GPT Image 2 中重新制作选定画面。这样既能获得一个模型的速度,也能得到另一个模型的纵深。
关于这个生成器的问题
- 我需要参考图吗? 生成第一张图时不需要。如果角色面孔或地点布局必须在整个系列中保持完全一致,就需要。GPT Image 2 接受参考图;Krea 2 不接受。
- 为什么我的动漫图像看起来像照片? 风格语句的约束太弱。明确写出线条质感、通透的色彩和低对比度的阴影表现,并在每次生成时重复同一句描述。
- 我可以在图像中生成文字吗? 尽量避免。两个模型都不能可靠地生成清晰可读的文字,而这更是 Krea 2 已知的弱项。请改在页面排版中添加标题。
- 一个世界应该有多少张图像? 四张足以验证一种视觉风格:两条提示词,两个模型。只有当场景需要新角度或新角色时,才添加更多图像。
生成你的第一张动漫主视觉
桥上场景和空教室的两个模型版本均已发布。打开世界,复制提示词框架,创作属于你的下一幅画面。